
前言
一般解决普通的区间历史和,只需要定义辅助,是历史和,是区间和,是时间戳,维护数组的区间加即可
但是如果题目更复杂一点,就要设置不同的tag,考虑下放顺序和影响,非常费脑子
一种无脑的方法就是构造矩阵,如果单纯使用普通的矩阵乘法,那么总复杂度会多,其中为向量长度
本文的目的就是优化矩阵乘法的过程,实际上就是对矩阵乘法循环展开,只不过个人认为能更优雅一点罢了
P8868 [NOIP2022] 比赛
题意给出两个数组,多次询问,的所有子区间的,也就是求
考虑对所有询问离线,从左到右扫一遍,维护以为右端点的答案,询问就是查询区间的历史和
对分别维护两个单调栈即可用线段树更新
线段树每个节点维护表示区间的和,的和,的和,的历史和,区间长度
那么对于区间加,有
同理,区间加,有
更新区间历史和
虽然矩阵乘法是,但是可以发现很多状态是一直为,也就是没有用的,要想找到这些状态,我们只需要将所有矩阵初始不为0的状态设为1,跑一遍传递闭包,就可以知道所有状态,这里25个状态一共只有14个状态合法(实际上可以9个,主对角线恒为1)
然后我们可以打表来代替手写,打表代码如下
void solve(){
    vector<vector<int>> f={
        {1,0,1,0,0},
        {0,1,1,0,0},
        {0,0,1,1,0},
        {0,0,0,1,0},
        {1,1,0,0,1}
    };
    const int n=f.size();
    for(int k=0;k<n;k++){
        for(int i=0;i<n;i++){
            for(int j=0;j<n;j++)f[i][j]|=f[i][k]&f[k][j];
        }
    }
    string s="int ";
    for(int i=0;i<n;i++){
        for(int j=0;j<n;j++){
            if(f[i][j])s+="x"+to_string(i)+to_string(j)+",";
        }
    }
    s.pop_back();
    s+=";\n";
    s+="\n\nMatrix * Matrix:\n";
    for(int i=0;i<n;i++){
        for(int j=0;j<n;j++){
            if(!f[i][j])continue;
            s+="res.x"+to_string(i)+to_string(j)+"=";
            for(int k=0;k<n;k++){
                if(f[i][k]&f[k][j])s+="a.x"+to_string(i)+to_string(k)+"*b.x"+to_string(k)+to_string(j)+"+";
            }
            s.pop_back();
            s+=";\n";
        }
    }
    s+="\n\nVec * Matrix:\n";
    for(int i=0;i<n;i++){
        s+="res.x0"+to_string(i)+"=";
        for(int j=0;j<n;j++){
            if(f[j][i]){
                s+="a.x0"+to_string(j)+"*b.x"+to_string(j)+to_string(i)+"+";
            }
        }
        s.pop_back();
        s+=";\n";
    }
    s.pop_back();
    cout<<s;
}
/*
打印结果:
int x00,x02,x03,x11,x12,x13,x22,x23,x33,x40,x41,x42,x43,x44;


Matrix * Matrix:
res.x00=a.x00*b.x00;
res.x02=a.x00*b.x02+a.x02*b.x22;
res.x03=a.x00*b.x03+a.x02*b.x23+a.x03*b.x33;
res.x11=a.x11*b.x11;
res.x12=a.x11*b.x12+a.x12*b.x22;
res.x13=a.x11*b.x13+a.x12*b.x23+a.x13*b.x33;
res.x22=a.x22*b.x22;
res.x23=a.x22*b.x23+a.x23*b.x33;
res.x33=a.x33*b.x33;
res.x40=a.x40*b.x00+a.x44*b.x40;
res.x41=a.x41*b.x11+a.x44*b.x41;
res.x42=a.x40*b.x02+a.x41*b.x12+a.x42*b.x22+a.x44*b.x42;
res.x43=a.x40*b.x03+a.x41*b.x13+a.x42*b.x23+a.x43*b.x33+a.x44*b.x43;
res.x44=a.x44*b.x44;


Vec * Matrix:
res.x00=a.x00*b.x00+a.x04*b.x40;
res.x01=a.x01*b.x11+a.x04*b.x41;
res.x02=a.x00*b.x02+a.x01*b.x12+a.x02*b.x22+a.x04*b.x42;
res.x03=a.x00*b.x03+a.x01*b.x13+a.x02*b.x23+a.x03*b.x33+a.x04*b.x43;
res.x04=a.x04*b.x44;
*/
然后我们就可以利用打印结果,快速套上线段树板子
struct Matrix{
    int x00,x02,x03,x11,x12,x13,x22,x23,x33,x40,x41,x42,x43,x44;
};
struct Vec{
    int x00,x01,x02,x03,x04;
};
Matrix operator*(const Matrix &a,const Matrix &b){
    Matrix res;
    res.x00=a.x00*b.x00;
    res.x02=a.x00*b.x02+a.x02*b.x22;
    res.x03=a.x00*b.x03+a.x02*b.x23+a.x03*b.x33;
    res.x11=a.x11*b.x11;
    res.x12=a.x11*b.x12+a.x12*b.x22;
    res.x13=a.x11*b.x13+a.x12*b.x23+a.x13*b.x33;
    res.x22=a.x22*b.x22;
    res.x23=a.x22*b.x23+a.x23*b.x33;
    res.x33=a.x33*b.x33;
    res.x40=a.x40*b.x00+a.x44*b.x40;
    res.x41=a.x41*b.x11+a.x44*b.x41;
    res.x42=a.x40*b.x02+a.x41*b.x12+a.x42*b.x22+a.x44*b.x42;
    res.x43=a.x40*b.x03+a.x41*b.x13+a.x42*b.x23+a.x43*b.x33+a.x44*b.x43;
    res.x44=a.x44*b.x44;
    return res;
}
Vec operator * (const Vec &a,const Matrix &b){
    Vec res;
    res.x00=a.x00*b.x00+a.x04*b.x40;
    res.x01=a.x01*b.x11+a.x04*b.x41;
    res.x02=a.x00*b.x02+a.x01*b.x12+a.x02*b.x22+a.x04*b.x42;
    res.x03=a.x00*b.x03+a.x01*b.x13+a.x02*b.x23+a.x03*b.x33+a.x04*b.x43;
    res.x04=a.x04*b.x44;
    return res;
}
Vec operator +(const Vec &a,const Vec &b){
    return {
        a.x00+b.x00,
        a.x01+b.x01,
        a.x02+b.x02,
        a.x03+b.x03,
        a.x04+b.x04
    };
}
Matrix I={1,0,0,1,0,0,1,0,1,0,0,0,0,1};
Matrix C={1,0,0,1,0,0,1,1,1,0,0,0,0,1};
Matrix getA(int k){
    return Matrix{1,0,0,1,k,0,1,0,1,k,0,0,0,1};
}
Matrix getB(int k){
    return Matrix{1,k,0,1,0,0,1,0,1,0,k,0,0,1};
}
vector<int> a,b;
struct SegmentTree{
    struct Node{
        Vec v;
        Matrix tag=I;
        bool lazy=0;
    };
    vector<Node> t;
    void init(int n){
        t=vector<Node>(n<<2);
        build(1,1,n);
    }
    void pushup(int p){
        t[p].v=t[p<<1].v+t[p<<1|1].v;
    }
    void pushtag(int p,const Matrix &m){
        t[p].v=t[p].v*m;
        t[p].tag=t[p].tag*m;
        t[p].lazy=1;
    }
    void pushdown(int p){
        if(t[p].lazy){
            pushtag(p<<1,t[p].tag);
            pushtag(p<<1|1,t[p].tag);
            t[p].lazy=0;
            t[p].tag=I;
        }
    }
    void build(int p,int l,int r){
        if(l==r){
            t[p].v={a[l],b[l],a[l]*b[l],0,1};
            return;
        }
        int mid=l+r>>1;
        build(p<<1,l,mid);
        build(p<<1|1,mid+1,r);
        pushup(p);
    }
    void modify(int p,int l,int r,int ql,int qr,const Matrix &x){
        if(ql<=l&&r<=qr){
            pushtag(p,x);
            return;
        }
        pushdown(p);
        int mid=l+r>>1;
        if(ql<=mid)modify(p<<1,l,mid,ql,qr,x);
        if(qr>mid)modify(p<<1|1,mid+1,r,ql,qr,x);
        pushup(p);
    }
    int query(int p,int l,int r,int ql,int qr){
        if(ql<=l&&r<=qr)return t[p].v.x03;
        pushdown(p);
        int res=0,mid=l+r>>1;
        if(ql<=mid)res+=query(p<<1,l,mid,ql,qr);
        if(qr>mid)res+=query(p<<1|1,mid+1,r,ql,qr);
        return res;
    }
} t;
void solve(){
    int n,m;
    cin>>m>>n;
    vector<int> sta(n+1),stb(n+1);
    a.assign(n+1,0);
    b.assign(n+1,0);
    for(int i=1;i<=n;i++)cin>>a[i];
    for(int i=1;i<=n;i++)cin>>b[i];
    t.init(n);
    cin>>m;
    vector<PII> Que[n+1];
    for(int i=0;i<m;i++){
        int l,r;
        cin>>l>>r;
        Que[r].emplace_back(l,i);
    }
    vector<int> ans(m);
    int at=0,bt=0;
    for(int i=1;i<=n;i++){
        while(at&&a[sta[at]]<a[i]){
            t.modify(1,1,n,sta[at-1]+1,sta[at],getA(a[i]-a[sta[at]]));
            --at;
        }sta[++at]=i;
        while(bt&&b[stb[bt]]<b[i]){
            t.modify(1,1,n,stb[bt-1]+1,stb[bt],getB(b[i]-b[stb[bt]]));
            --bt;
        }stb[++bt]=i;
        t.modify(1,1,n,1,i,C);
        for(auto [l,id]:Que[i]){
            ans[id]=t.query(1,1,n,l,i);
        }
    }
    for(int i=0;i<m;i++)cout<<ans[i]<<"\n";
}
这样就可以通过此题了,复杂度大概能快个10倍
CF1824D
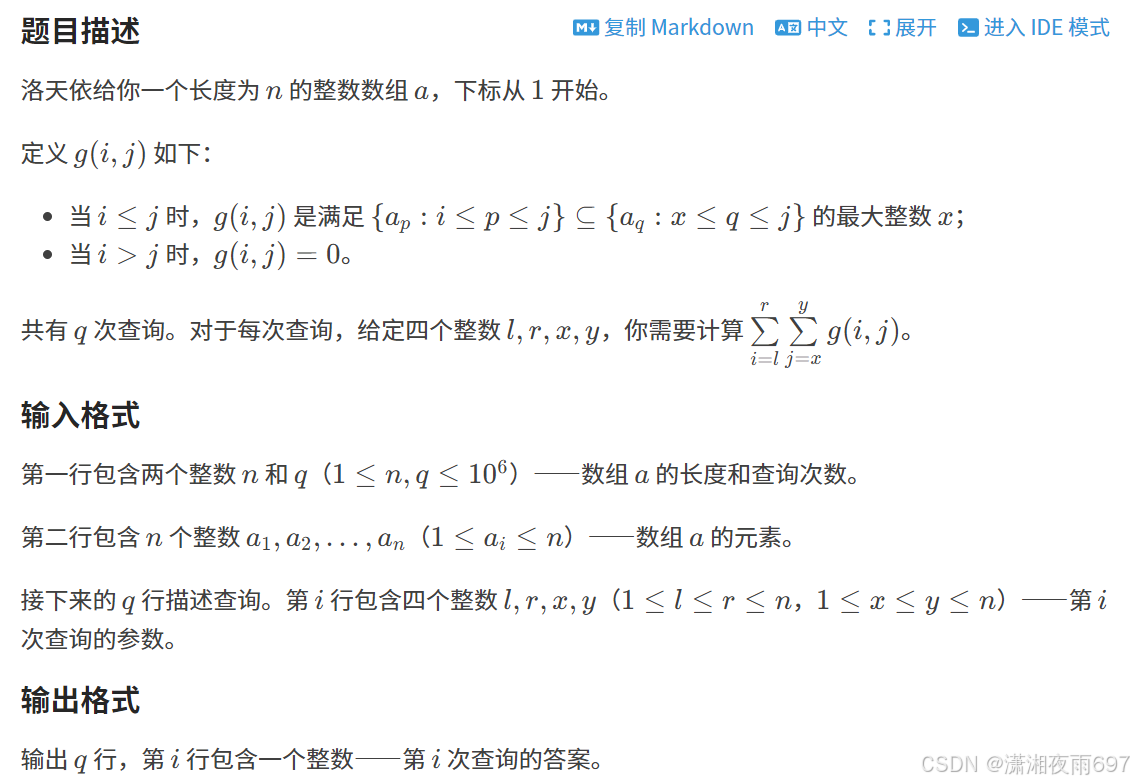 首先一样的套路,离线从左到右扫,差分一下,即求
用一个set维护最后一个数出现的位置,那么i对于一个,考虑哪些的贡献发生改变,手玩一下发现是一段区间覆盖,可以用区间加代替
那么区间加,区间历史和,就是套版子了 维护向量表示和,历史和,长度
区间加矩阵:
更新矩阵
打表简化常数,最终发现只需要维护6个变量 按照之前的步骤写,不需要手动卡常也能过
struct Matrix{
    int x00,x01,x11,x20,x21,x22;
};
struct Vec{
    int x00,x01,x02;
};
Matrix operator*(const Matrix &a,const Matrix &b){
    Matrix res;
    res.x00=a.x00*b.x00;
    res.x01=a.x00*b.x01+a.x01*b.x11;
    res.x11=a.x11*b.x11;
    res.x20=a.x20*b.x00+a.x22*b.x20;
    res.x21=a.x20*b.x01+a.x21*b.x11+a.x22*b.x21;
    res.x22=a.x22*b.x22;
    return res;
}
Vec operator * (const Vec &a,const Matrix &b){
    Vec res;
    res.x00=a.x00*b.x00+a.x02*b.x20;
    res.x01=a.x00*b.x01+a.x01*b.x11+a.x02*b.x21;
    res.x02=a.x02*b.x22;
    return res;
}
Vec operator +(const Vec &a,const Vec &b){
    return {
        a.x00+b.x00,
        a.x01+b.x01,
        a.x02+b.x02,
    };
}
Matrix I={1,0,1,0,0,1};
Matrix C={1,1,1,0,0,1};
Matrix getA(int k){
    return Matrix{1,0,1,k,0,1};
}
vector<int> a,b;
struct SegmentTree{
    struct Node{
        Vec v;
        Matrix tag=I;
        bool lazy=0;
    };
    vector<Node> t;
    void init(int n){
        t=vector<Node>(n<<2);
        build(1,1,n);
    }
    void pushup(int p){
        t[p].v=t[p<<1].v+t[p<<1|1].v;
    }
    void pushtag(int p,const Matrix &m){
        t[p].v=t[p].v*m;
        t[p].tag=t[p].tag*m;
        t[p].lazy=1;
    }
    void pushdown(int p){
        if(t[p].lazy){
            pushtag(p<<1,t[p].tag);
            pushtag(p<<1|1,t[p].tag);
            t[p].lazy=0;
            t[p].tag=I;
        }
    }
    void build(int p,int l,int r){
        if(l==r){
            t[p].v={0,0,1};
            return;
        }
        int mid=l+r>>1;
        build(p<<1,l,mid);
        build(p<<1|1,mid+1,r);
        pushup(p);
    }
    void modify(int p,int l,int r,int ql,int qr,const Matrix &x){
        if(ql<=l&&r<=qr){
            pushtag(p,x);
            return;
        }
        pushdown(p);
        int mid=l+r>>1;
        if(ql<=mid)modify(p<<1,l,mid,ql,qr,x);
        if(qr>mid)modify(p<<1|1,mid+1,r,ql,qr,x);
        pushup(p);
    }
    int query(int p,int l,int r,int ql,int qr){
        if(ql<=l&&r<=qr)return t[p].v.x01;
        pushdown(p);
        int res=0,mid=l+r>>1;
        if(ql<=mid)res+=query(p<<1,l,mid,ql,qr);
        if(qr>mid)res+=query(p<<1|1,mid+1,r,ql,qr);
        return res;
    }
} t;
void solve(){
    int n,q;
    cin>>n>>q;
    vector<int> a(n+1);
    for(int i=1;i<=n;i++)cin>>a[i];
    vector<int> ans(q);
    vector<array<int,4>> Que[n+1];
    for(int i=0;i<q;i++){
        int l,r,L,R;
        cin>>l>>r>>L>>R;
        Que[R].push_back({l,r,i,1});
        Que[L-1].push_back({l,r,i,-1});
    }
    t.init(n);
    set<int> s={0};
    vector<int> pre(n+1);
    for(int i=1;i<=n;i++){
        if(pre[a[i]]){
            auto j=s.lower_bound(pre[a[i]]);
            int l=*prev(j)+1,r=*j;
            int v=(next(j)==s.end())?i-*j:*next(j)-*j;
            // cout<<l<<" "<<r<<" "<<v<<"\n";
            t.modify(1,1,n,l,r,getA(v));
            s.erase(j);
        }
        t.modify(1,1,n,i,i,getA(i));
        pre[a[i]]=i;
        s.insert(i);
        t.modify(1,1,n,1,i,C);
        for(auto [l,r,id,op]:Que[i]){
            r=min(r,i);
            ans[id]+=op*t.query(1,1,n,l,r);
        }
    }
    for(int i=0;i<q;i++)cout<<ans[i]<<"\n";
}
P9990/2020 ICPC EcFinal G
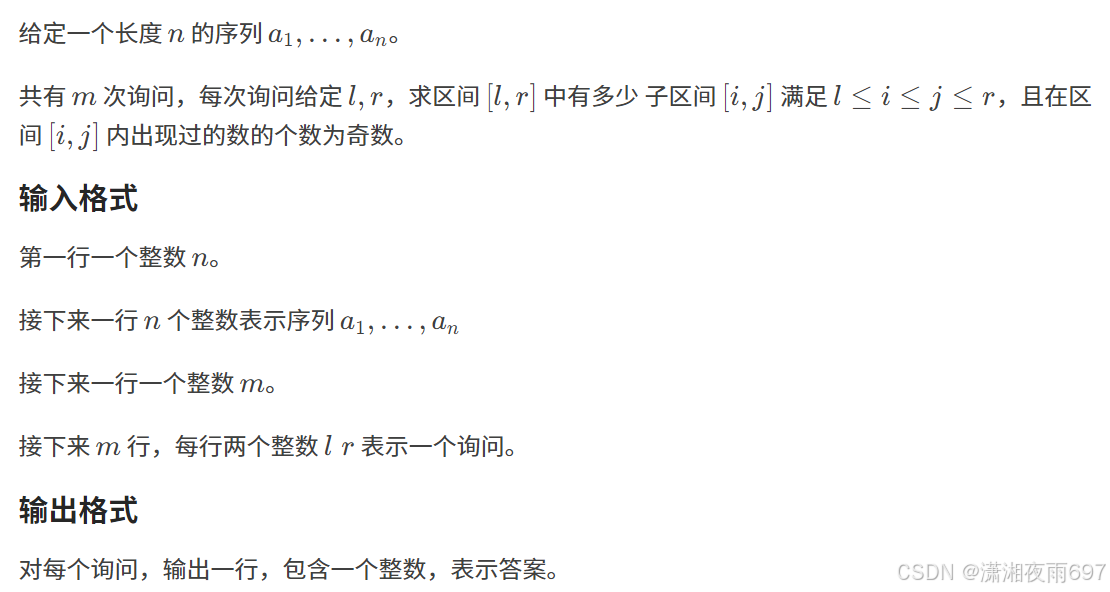 考虑离线,从1到n枚举,维护以当前为右端点的合法左端点,表示是否合法,可以发现影响的范围为这些范围的数的个数都会+1,在模2意义下就是翻转。对于区间查询我们就是查询区间的历史版本和
一个简单的方法就是矩阵表示,每个节点维护矩阵分别表示个数和历史版本和
那么对于翻转操作,应该要变成,可以构造出矩阵
不翻转的贡献是,即乘上矩阵
以下是套模板的代码
#include<bits/stdc++.h>
#include<ext/pb_ds/assoc_container.hpp>
#include<ext/pb_ds/tree_policy.hpp>
using namespace std;
using namespace __gnu_pbds;
#define int long long
#define F first
#define S second
#define TR tree<int,null_type,less<int>,rb_tree_tag,tree_order_statistics_node_update>
typedef pair<int,int> PII;
const int N=2e6+10,M=2e5+10;
const int INF=1e18;
const int mod=998244353;
// const int mod=1e9+7;
mt19937_64 rng(chrono::steady_clock::now().time_since_epoch().count());
struct Vec{
    int x00,x01,x02;
};
struct Matrix{
    int x00,x01,x02,x10,x11,x12,x22;
};
Matrix operator *(const Matrix &a,const Matrix &b){
    Matrix res;
    res.x00=a.x00*b.x00+a.x01*b.x10;
    res.x01=a.x00*b.x01+a.x01*b.x11;
    res.x02=a.x00*b.x02+a.x01*b.x12+a.x02*b.x22;
    res.x10=a.x10*b.x00+a.x11*b.x10;
    res.x11=a.x10*b.x01+a.x11*b.x11;
    res.x12=a.x10*b.x02+a.x11*b.x12+a.x12*b.x22;
    res.x22=a.x22*b.x22;

    return res;
}
Vec operator *(const Vec &a,const Matrix &b){
    Vec res;
    res.x00=a.x00*b.x00+a.x01*b.x10;
    res.x01=a.x00*b.x01+a.x01*b.x11;
    res.x02=a.x00*b.x02+a.x01*b.x12+a.x02*b.x22;
    return res;
}
Vec operator +(const Vec &a,const Vec &b){
    return {a.x00+b.x00, a.x01+b.x01, a.x02+b.x02};
}
Matrix I={1,0,0,0,1,0,1};
Matrix A={0,1,1,1,0,0,1};
Matrix B={1,0,0,0,1,1,1};
struct SegmentTree{
    struct Node{
        Vec m;
        Matrix tag=I;
        bool lazy=0;
    };
    vector<Node> t;
    void init(int n){
        t=vector<Node>(n<<2);
        build(1,1,n);
    }
    void pushup(int p){
        t[p].m=t[p<<1].m+t[p<<1|1].m;
    }
    void pushtag(int p,const Matrix &x){
        t[p].m=t[p].m*x;
        t[p].tag=t[p].tag*x;
        t[p].lazy=1;
    }
    void pushdown(int p){
        if(t[p].lazy){
            pushtag(p<<1,t[p].tag);
            pushtag(p<<1|1,t[p].tag);
            t[p].lazy=0;
            t[p].tag=I;
        }
    }
    void build(int p,int l,int r){
        if(l==r){
            t[p].m={1,0,0};
            return;
        }
        int mid=l+r>>1;
        build(p<<1,l,mid);
        build(p<<1|1,mid+1,r);
        pushup(p);
    }
    void modify(int p,int l,int r,int ql,int qr,const Matrix &x){
        if(ql<=l&&r<=qr){
            pushtag(p,x);
            return;
        }
        pushdown(p);
        int mid=l+r>>1;
        if(ql<=mid)modify(p<<1,l,mid,ql,qr,x);
        if(qr>mid)modify(p<<1|1,mid+1,r,ql,qr,x);
        pushup(p);
    }
    int query(int p,int l,int r,int ql,int qr){
        if(ql<=l&&r<=qr)return t[p].m.x02;
        pushdown(p);
        int res=0,mid=l+r>>1;
        if(ql<=mid)res+=query(p<<1,l,mid,ql,qr);
        if(qr>mid)res+=query(p<<1|1,mid+1,r,ql,qr);
        return res;
    }
};
void solve(){
    int n;
    cin>>n;
    SegmentTree t;
    t.init(n);
    vector<int> a(n+1);
    for(int i=1;i<=n;i++)cin>>a[i];
    int m;
    cin>>m;
    vector<PII> Que[n+1];
    vector<int> ans(m);
    for(int i=0;i<m;i++){
        int l,r;
        cin>>l>>r;
        Que[r].emplace_back(l,i);
    }
    vector<int> lst(n+1);
    for(int i=1;i<=n;i++){
        t.modify(1,1,n,lst[a[i]]+1,i,A);
        if(lst[a[i]])t.modify(1,1,n,1,lst[a[i]],B);
        lst[a[i]]=i;
        for(auto &[l,id]:Que[i]){
            ans[id]=t.query(1,1,n,l,i);
        }
    }
    for(int i=0;i<m;i++)cout<<ans[i]<<"\n";
}
signed main(){
    cin.tie(0)->sync_with_stdio(0);
    int T=1;
    // cin>>T;
    while(T--)solve();
    return 0;
}
拿CF的数据测试 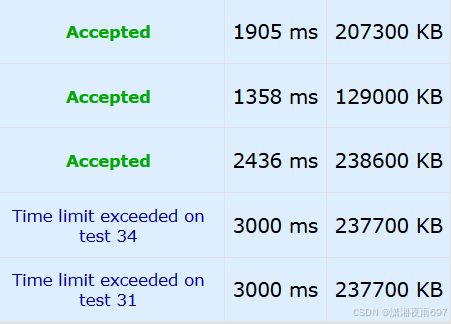 从上到下分别是改良后的矩阵乘法(即本文章使用的),多重标记(正解),矩阵乘法(仅循环展开未减少状态运算),以及两个普通的矩阵乘法(由于大常数超时)
可以看到优化还是很明显的,比赛的时候时间充足找不到打多重标记的做法可以使用,优点就是非常套路,缺点就是代码量会大一点,并且非常难调(几个初始矩阵一定要用对)